
در سال ۲۰۲۳ ایدهٔ «DALL·E برای صدا» بیشتر شبیه آیندهنگری بود: پرودیوسر چند جمله دربارهٔ کیک، اسنیر یا پد موردنظرش بنویسد و هوش مصنوعی یک فایل صوتی تازه تحویل دهد. امروز این تصور تا حد زیادی به ابزار واقعی تبدیل شده است. مدلهای Text-to-Audio میتوانند از توضیح متنی موسیقی و افکت صوتی بسازند و ابزارهایی مانند Audialab Emergent Drums 2 مستقیماً داخل ورکفلو آهنگسازی، سمپل درام تازه یا واریاسیون یک سمپل موجود تولید میکنند.
بااینحال، «تولید صدا» با «تولید موسیقی خوب» یکسان نیست. خروجی هوش مصنوعی هنوز به انتخاب، ویرایش، کوک، تنظیم داینامیک، چیدمان ریتم و تصمیم هنری پرودیوسر نیاز دارد. در این مقاله بررسی میکنیم فناوری مولد صوت چگونه کار میکند، در بیتمیکینگ چه کمکی میکند، محدودیتهای عملی و حقوقی آن چیست و چگونه بدون از دست دادن هویت شخصی از آن استفاده کنیم.
از ایدهٔ DALL·E صوتی تا ابزار واقعی
مدلهای تصویرساز نشان دادند که زبان طبیعی میتواند رابط کاربری یک موتور مولد باشد. پژوهشگران و شرکتهای صوتی همین منطق را به موسیقی و طراحی صدا منتقل کردند: کاربر بهجای جستوجوی هزاران فایل، ویژگیهای منبع، جنس، سبک، شدت، فضا و مدت را توصیف میکند و مدل چند خروجی پیشنهادی میسازد.
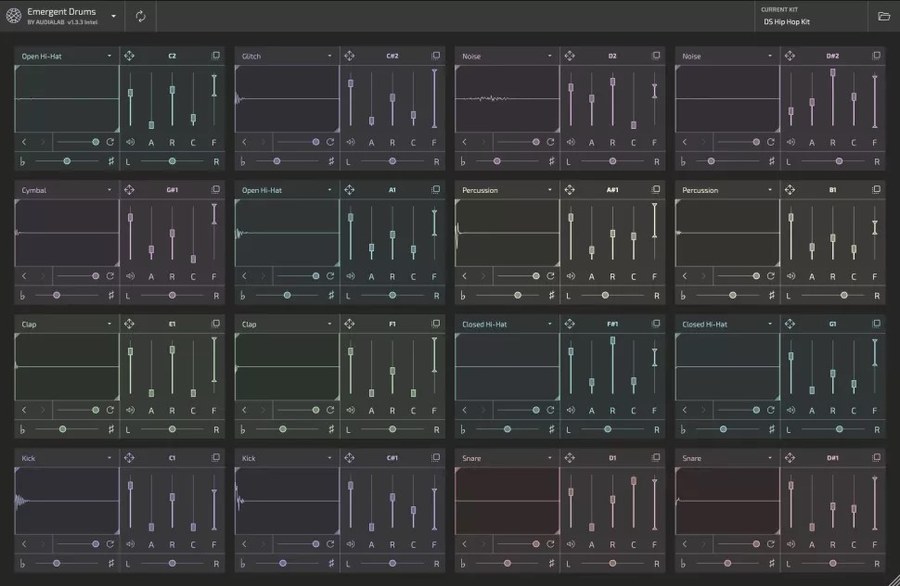
Audialab این ایده را در حوزهٔ درام به محصولی تخصصی تبدیل کرده است. Emergent Drums 2 روی تولید سمپلهای کوتاه تمرکز دارد و بهجای ساخت یک آهنگ کامل، اجزای قابلکنترل بیت را در اختیار پرودیوسر میگذارد. طبق توضیح رسمی شرکت، مدل میتواند سمپل تازه را از ابتدا تولید کند یا با فناوری Deep Sampling از فایل شخصی کاربر واریاسیون بسازد.
در طرف دیگر، سرویسهایی مانند Stable Audio از متن یا فایل صوتی ورودی برای ساخت موسیقی، افکت و بافت صوتی استفاده میکنند. نسلهای جدید این فناوری میتوانند خروجی طولانیتر، استریو و قابلتبدیل از Audio-to-Audio بسازند. بنابراین پیشبینی قدیمی مقاله—توصیف یک صدا و دریافت نمونه—دیگر صرفاً رویا نیست؛ مسئلهٔ امروز کیفیت، کنترل، مجوز و جایگاه خروجی در فرایند خلاقه است.
هوش مصنوعی مولد صدا چگونه کار میکند؟
مدل مولد صوت با مجموعهای از فایلهای صوتی و اطلاعات همراه آموزش میبیند. در مرحلهٔ آموزش، الگوهای آماری مربوط به طیف، ترنزینت، ریتم، بافت، سازبندی و ارتباط آنها با برچسب یا متن یاد گرفته میشوند. مدل در زمان تولید، فایل موجود را از دیتابیس کپی نمیکند؛ با استفاده از نمایش آموختهشده، سیگنال تازهای میسازد. بااینحال، میزان تازگی و احتمال شباهت به دادهٔ آموزش به معماری، دیتاست و شیوهٔ آموزش وابسته است.
بسیاری از سیستمهای جدید صدا را در یک فضای فشرده یا Latent پردازش میکنند. این روش نسبت به ساخت مستقیم تکتک سمپلهای موج، محاسبات را کاهش میدهد. متن نیز با یک Encoder به نمایش عددی تبدیل میشود تا مفاهیمی مانند «کیک کوتاه و پانچ با سچوریشن آنالوگ» به ویژگیهای صوتی مرتبط شوند.
مدل تخصصی درام با مدل آهنگ کامل تفاوت دارد. سمپل درام معمولاً کوتاه، بدون ساختار زمانی بلند و دارای ترنزینت مشخص است؛ بنابراین کنترل Attack، Decay، Pitch و رنگ صوتی اهمیت بیشتری از هارمونی و فرم دارد. مدل موسیقی بلند باید ریتم، تکرار، توسعه و انسجام چنددقیقهای را نیز حفظ کند.
ساخت سمپل درام با هوش مصنوعی
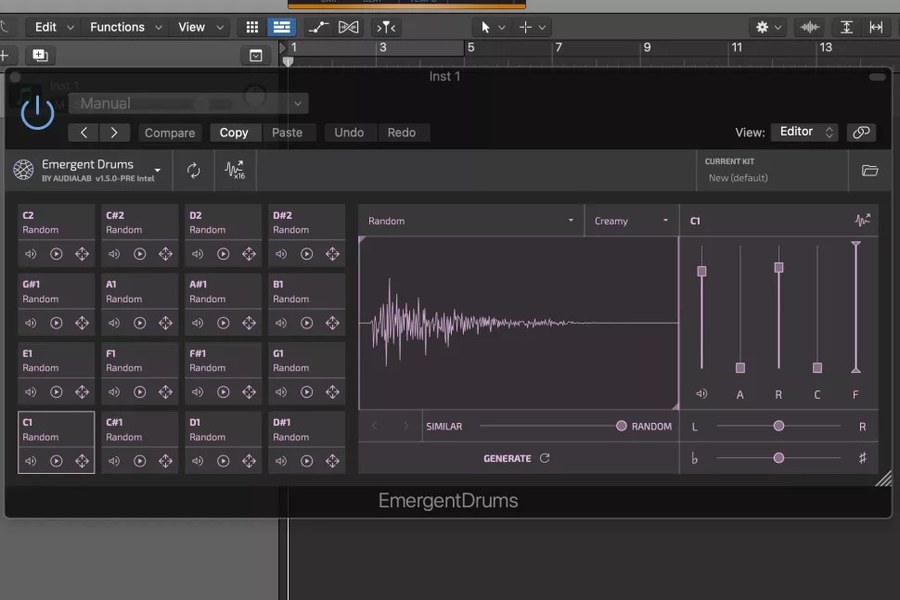
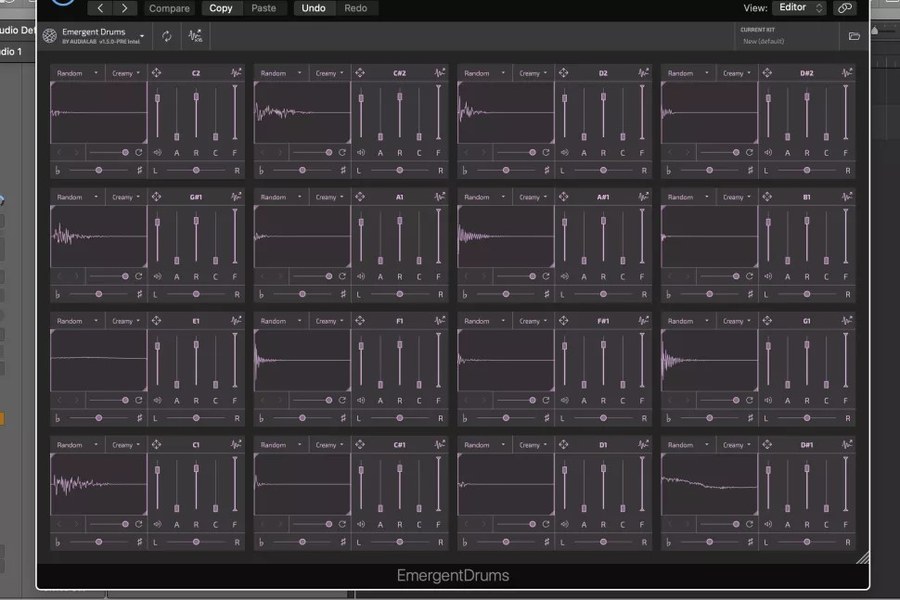
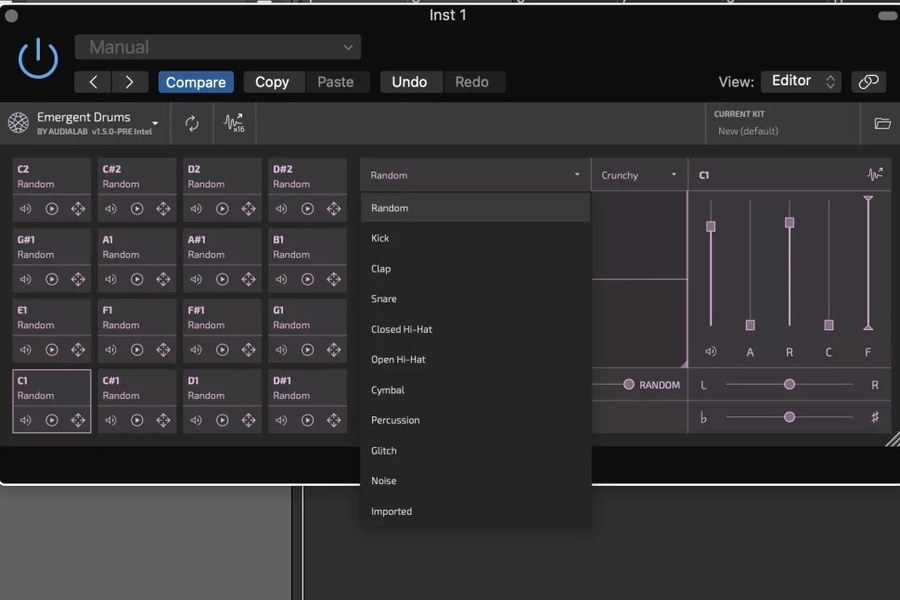
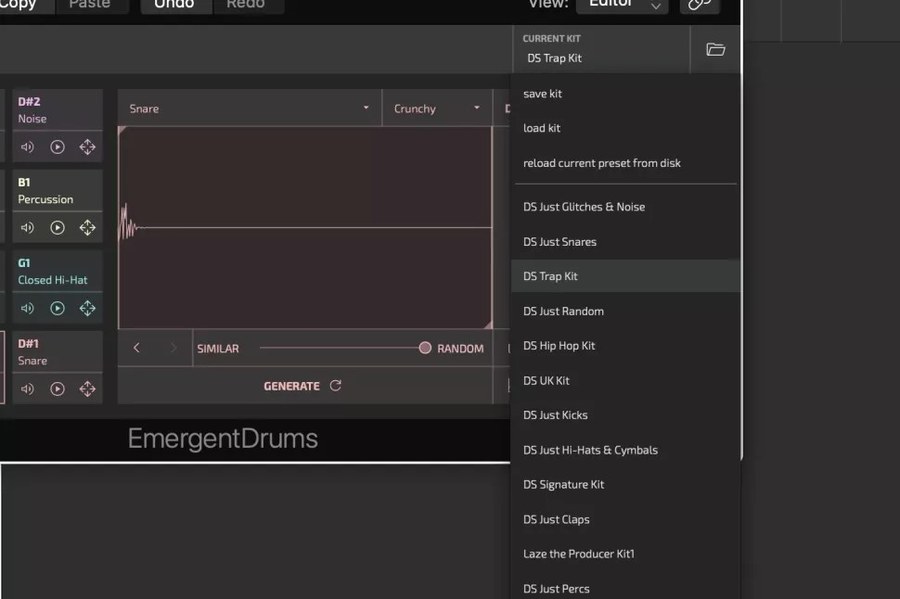
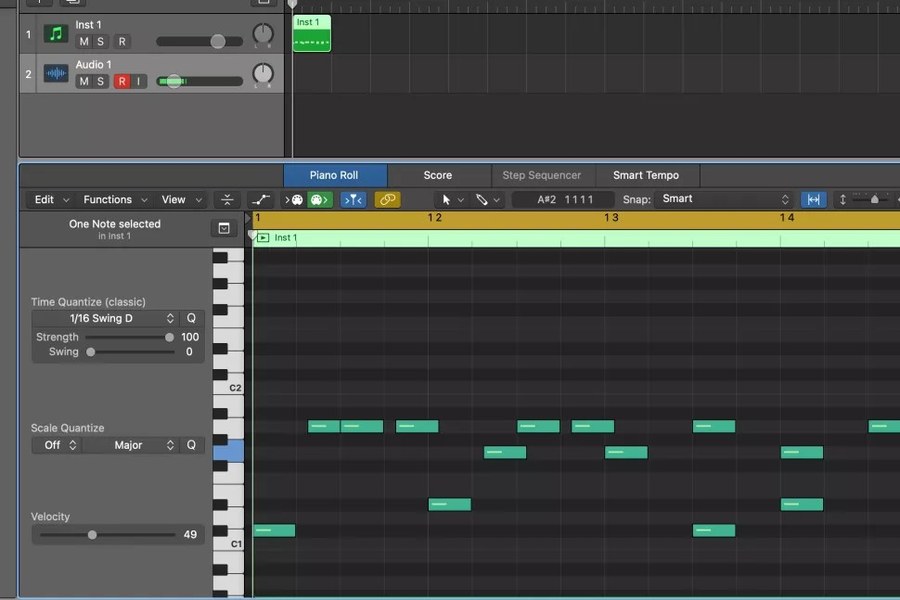
مزیت تولید سمپل درام، سرعت ساخت چندین گزینهٔ نزدیک به هدف است. بهجای مرور پکیجهای بزرگ، نوع صدا را انتخاب میکنید و چند نسل میسازید. در Emergent Drums 2 هر کیت ۱۶ پد دارد، با MIDI اجرا میشود و سمپلها را میتوان مستقیم به DAW درگ کرد. خروجیها برای استفادهٔ مستقل طراحی شدهاند و ابزارهای داخلی Trim، Gain، Attack، Release، Pitch، Filter و Clip به آمادهسازی آنها کمک میکنند.
برای نتیجهٔ بهتر، تولید را جایگزین انتخاب آگاهانه نکنید. در هر دور فقط چند گزینه بسازید و آنها را در بافت بیت گوش دهید. کیکی که بهتنهایی بزرگ و هیجانانگیز است ممکن است با خط باس تداخل داشته باشد؛ اسنیر روشن نیز ممکن است فضای وکال را اشغال کند.
پس از انتخاب، مراحل معمول طراحی صدا همچنان ضروریاند: نقطهٔ شروع فایل را دقیق کنید، فاز کیک و باس را بسنجید، Tail را به تمپو هماهنگ کنید و سطح را پیش از پردازش کاهش دهید. اگر چند سمپل را Layer میکنید، هر لایه باید نقش مشخصی داشته باشد—برای نمونه یک لایه برای ترنزینت و دیگری برای بدنه—وگرنه نتیجه فقط بلندتر و مبهمتر میشود.
ساخت واریاسیون از سمپل موجود
Audio-to-Audio یا Sample-to-Sample بهجای شروع از متن خالی، ویژگیهای یک فایل ورودی را مبنا قرار میدهد. این روش وقتی مفید است که ریتم، Envelope یا شخصیت کلی یک سمپل را دوست دارید اما به نسخهای تیرهتر، نرمتر یا متفاوت نیاز دارید.
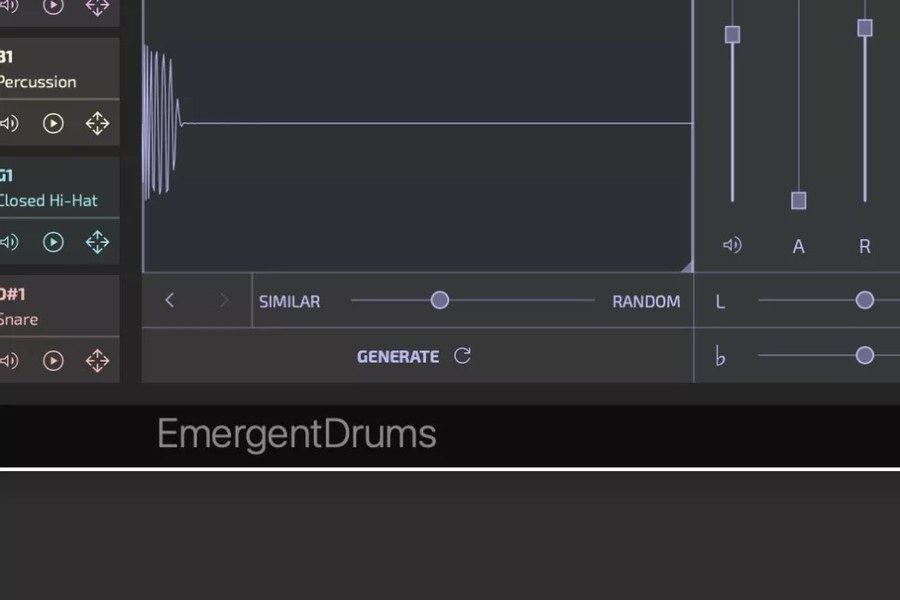
Similarity Slider در Emergent Drums 2 میزان نزدیک بودن نسل جدید به سمپل مرجع را کنترل میکند. مقدار نزدیکتر برای ساخت Round Robin و جلوگیری از تکرار مکانیکی مناسب است؛ مقدار دورتر برای کشف صداهای غیرمنتظره کاربرد دارد. بهتر است فایل اصلی را نگه دارید و خروجیهای منتخب را با نام، BPM، Key و نقش صوتی آرشیو کنید.
در Loopهای ملودیک، واریاسیون ممکن است کوک یا محتوای هارمونیک را تغییر دهد. پیش از استفاده، خروجی را با تیونر و گوش بررسی کنید. همچنین Mono Compatibility و فاز را بسنجید؛ بعضی مدلها پهنای استریوی چشمگیری میسازند که در جمع شدن به مونو ضعیف میشود.
Text-to-Audio در آهنگسازی
Text-to-Audio در بیتمیکینگ فقط برای ساخت آهنگ کامل نیست. کاربردهای کنترلپذیرتر عبارتاند از تولید تکشات، بافت، نویز محیطی، رایزر، Impact، Ambience، ایدهٔ ریتمیک و لایهٔ مکمل. این فایلها میتوانند مواد اولیهٔ یک سینتی سایزر سمپلمحور یا Granular باشند.
اگر مدل یک پد اتمسفریک طولانی تولید میکند، لازم نیست کل فایل را بدون تغییر استفاده کنید. بخش مطلوب را ببرید، Fade بسازید، کوک کنید، در سمپلر قرار دهید و با Envelope و فیلتر آن را به ساز شخصی تبدیل کنید. ارزش خلاقه اغلب در همین مرحلهٔ انتخاب و تبدیل شکل میگیرد.
ورکفلو عملی بیتمیکینگ با هوش مصنوعی
- هدف را تعریف کنید: پیش از تولید بدانید به چه نقش صوتی نیاز دارید؛ کیک، اسنیر، تکسچر یا پد.
- محدوده بسازید: تمپو، گام، طول، شدت و جایگاه فرکانسی را مشخص کنید.
- چند گزینه تولید کنید: بهجای صدها فایل، سه تا هشت خروجی بسازید و سریع مقایسه کنید.
- در کانتکست انتخاب کنید: صدا را همراه باس، وکال یا سازهای اصلی گوش دهید.
- ویرایش فنی انجام دهید: Trim، Fade، Gain، Pitch، Phase و Envelope را اصلاح کنید.
- شخصیسازی کنید: Layer، Resample، Distortion، فیلتر یا مدولاسیون اضافه کنید.
- مستندسازی کنید: منبع ابزار، تاریخ، نسخهٔ مدل و شرایط مجوز را کنار فایل نگه دارید.
این روند مانع «اسکرول بیپایان» میان خروجیها میشود. محدود کردن تعداد نسلها به تصمیمگیری کمک میکند و اجازه نمیدهد انتخاب صدا جای آهنگسازی را بگیرد. اگر پس از چند دور هنوز نتیجه نزدیک نیست، پرامپت یا نقش صوت را بازتعریف کنید؛ تولید بیشتر با دستور مبهم معمولاً فقط گزینههای نامرتبط بیشتری میسازد.
چگونه پرامپت صوتی دقیق بنویسیم؟
پرامپت خوب شبیه بریف طراحی صداست. بهتر است بهجای ارجاع صرف به نام یک هنرمند یا قطعه، ویژگیهای شنیداری را توصیف کنید. این روش هم کنترل بیشتری ایجاد میکند و هم خطر تقلید مستقیم را کاهش میدهد.
| مولفه | نمونهٔ توصیف |
|---|---|
| منبع | کیک الکترونیک، اسنیر آکوستیک، پد آنالوگ |
| Envelope | Attack تیز، Decay کوتاه، Tail کنترلشده |
| رنگ صوتی | تیره، فلزی، گرم، دانهدار، روشن |
| پردازش | سچوریشن ملایم، Bitcrush کم، ریورب طولانی |
| فضا | خشک و نزدیک، اتاق کوچک، سالن بزرگ |
| کاربرد | برای بیسموزیک در ۱۴۰ BPM، فضای کافی برای ساببیس |
نمونهٔ پرامپت دقیقتر: «کیک الکترونیک کوتاه با ترنزینت واضح، بدنهٔ متمرکز در محدودهٔ میانی پایین، بدون ساببیس طولانی، کمی سچوریشن آنالوگ، مناسب بیت ۱۴۰ BPM». این دستور اطلاعات بیشتری از «یک کیک شبیه فلان هنرمند» در اختیار مدل میگذارد.
محدودیتها و کنترل کیفیت
خروجی مدل ممکن است نویز، کلیک، Tail غیرطبیعی، فاز نامطمئن یا جزئیات دیجیتال ناخواسته داشته باشد. هر فایل را در Waveform بررسی کنید و با هدفون و مانیتور گوش دهید. قلههای بینسمپلی، DC Offset و محتوای بسیار پایین را نیز در صورت لزوم کنترل کنید.
مدل همیشه زبان موسیقی را دقیق تفسیر نمیکند. واژههایی مانند «گرم»، «آنالوگ» یا «پانچی» معانی وابسته به سبک دارند. نتیجهٔ قابلتکرار به آزمون، نگهداری Seed یا تاریخچه و ثبت پرامپت نیاز دارد. همچنین سرویس ابری ممکن است مدل خود را تغییر دهد و همان دستور در آینده خروجی دیگری بسازد.
در تولید موسیقی کامل، انسجام بلندمدت، ملودی هدفمند و میکس تفکیکشده هنوز چالشاند. حتی خروجی چشمگیر نیز ممکن است از نظر فرم یکنواخت یا از نظر هارمونی نامطمئن باشد. پرودیوسر باید فایل را مانند یک اجرای خام ارزیابی کند، نه نتیجهٔ نهایی مستر.
حق نشر، دیتاست و اخلاق
شرایط استفادهٔ تجاری ابزارها یکسان نیست و ممکن است تغییر کند. پیش از انتشار، مجوز نسخهٔ مورد استفاده را بخوانید و بدانید آیا خروجی Royalty-Free است، آیا اشتراک خاصی برای استفادهٔ تجاری لازم است و فایل ورودی شما چگونه ذخیره یا برای آموزش استفاده میشود.
Audialab دربارهٔ Emergent Drums 2 خروجیهای Royalty-Free و تولید از مدل آموزشدیده روی مجموعهٔ سمپلهای درام را اعلام میکند. Stability AI نیز برای بعضی مدلهای Stable Audio بر استفاده از دادههای دارای مجوز و Creative Commons تأکید کرده است. این ادعاها مربوط به ابزار مشخصاند و نباید به تمام مدلهای موسیقی تعمیم داده شوند.
از درخواست تقلید دقیق صدای هنرمند زنده، بازسازی وکال بدون رضایت یا استفاده از فایل خصوصی دیگران خودداری کنید. اگر خروجی شباهت آشکاری به اثر شناختهشده دارد، آن را منتشر نکنید یا بهطور اساسی بازطراحی کنید. شفافیت دربارهٔ استفادهٔ مهم از هوش مصنوعی نیز در پروژههای سفارشی و همکاری حرفهای اعتماد ایجاد میکند.
آیندهٔ نقش پرودیوسر
هوش مصنوعی احتمالاً زمان جستوجو و کارهای تکراری را کم میکند، اما نقش پرودیوسر را حذف نمیکند. وقتی تولید گزینه ارزان و سریع شود، ارزش انتخاب، سلیقه، روایت، تنظیم و توانایی ایجاد انسجام بیشتر میشود. کسی که فقط «خروجی مدل» تحویل میدهد با هزاران خروجی مشابه رقابت میکند؛ کسی که آن را به زبان شخصی تبدیل میکند همچنان هویت دارد.
مهارت آینده ترکیبی است: گوش آموزشدیده، درک ریتم و هارمونی، طراحی صدا، شناخت حقوق و توانایی نوشتن بریف دقیق برای مدل. پرودیوسر باید بداند چه زمانی از AI کمک بگیرد و چه زمانی ضبط، سینتیسایز دستی یا انتخاب سمپل موجود سریعتر و معتبرتر است.
جمعبندی
سناریویی که زمانی «DALL·E برای صدا» نامیده میشد، اکنون در شکل ابزارهای تولید درام، Text-to-Audio و Audio-to-Audio وجود دارد. Emergent Drums 2 میتواند سمپلهای درام تازه و واریاسیون فایل موجود بسازد؛ Stable Audio و مدلهای مشابه نیز متن را به موسیقی، افکت و بافت تبدیل میکنند.
اما آیندهٔ درخشان بیتمیکینگ با یک دکمه ساخته نمیشود. مدل مولد زمانی ارزشمند است که جستوجو را کوتاه کند، ایدهٔ تازه بدهد و مادهٔ خام قابلپردازش تولید کند. مسئولیت انتخاب، کنترل کیفیت، رعایت حقوق و تبدیل خروجی به قطعهای دارای معنا همچنان بر عهدهٔ انسان است.
منابع: صفحهٔ رسمی Audialab Emergent Drums 2، Stable Audio و مستندات رسمی Stability AI.